先说结论
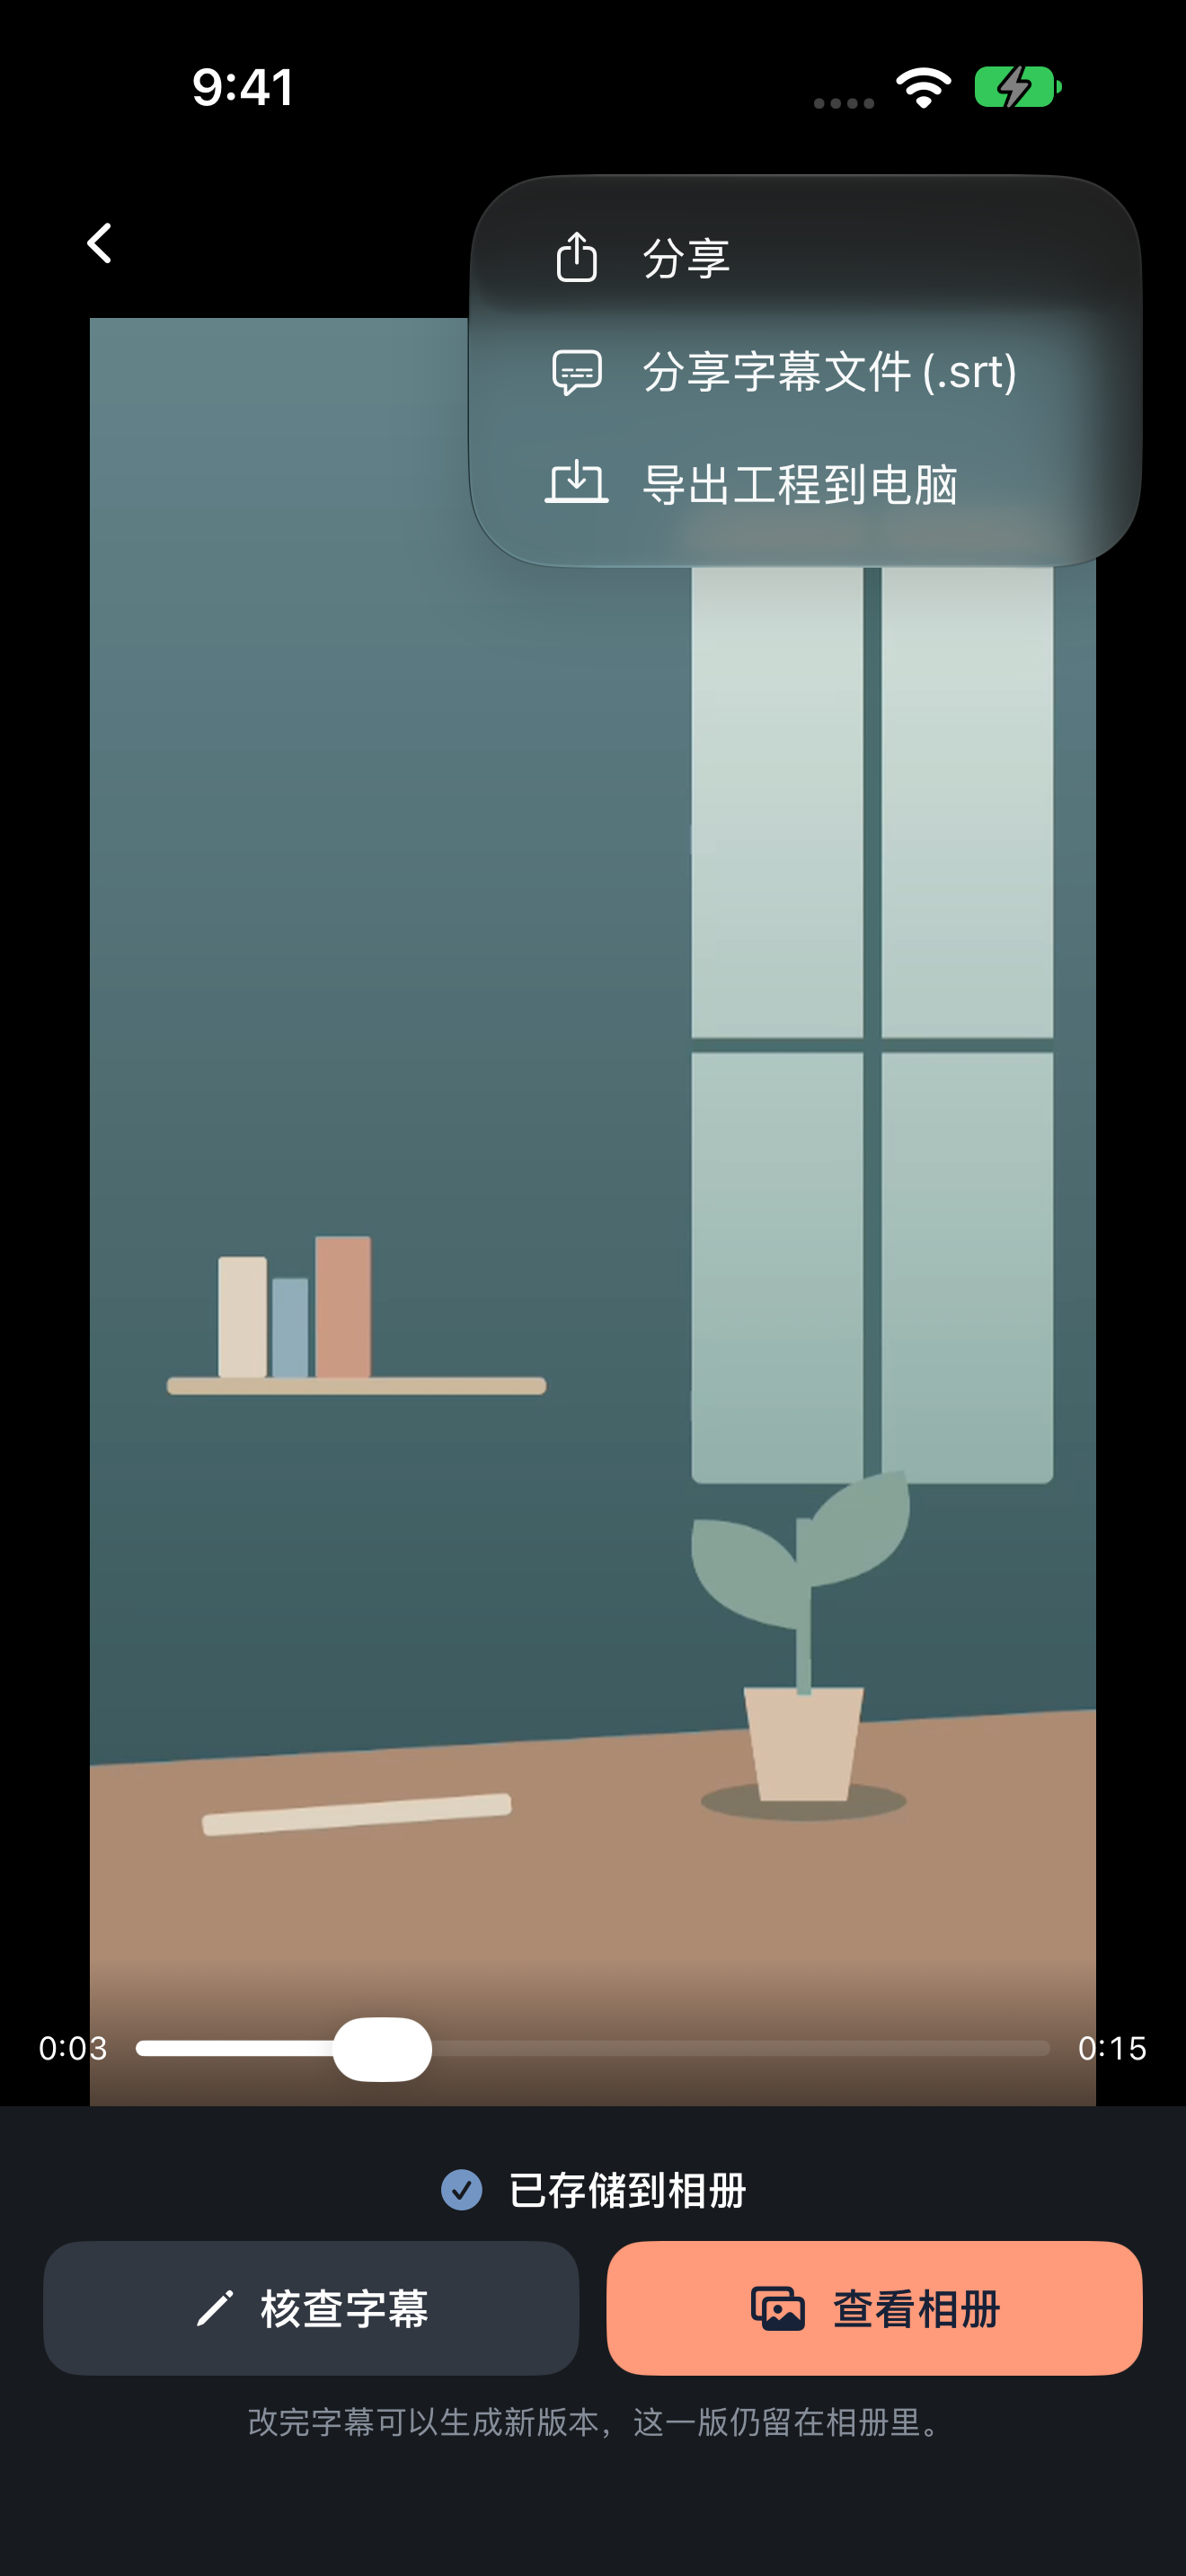
FoxTake 用本机语音识别生成字幕,稿子只用来辅助纠错。识别会出错,错得最多的是人名、数字、单位、否定词和专业术语。发布前要做的是:对着声音核对,改错的字,再决定烧录进视频还是导出 SRT。改字幕文字不会改变时间轴;2.0.1 起成片后也能改字幕再生成新版本,旧视频保留。
字幕生成是一键成片的一部分,扣积分。识别语言取决于本机语音资源,普通话、英语、粤语各自要有系统资源。
1. 录音才是正本,稿子不是
录的时候你可能临时加了例子、改了日期、补了限定。这些说出来的改动不该被稿子里更早的写法替换掉。所以字幕按你说的话识别,稿子只是提示哪些字可能识别错了。
成片前确认录入语言和这条录制实际讲的语言一致。2.0.1 起录入语言、跟随语言分别选择;选错语言,识别结果整段都不可用。
2. 打开字幕审核
- 在一键成片的选项里开启字幕,并选择输出方式(烧录、SRT 或两者)。
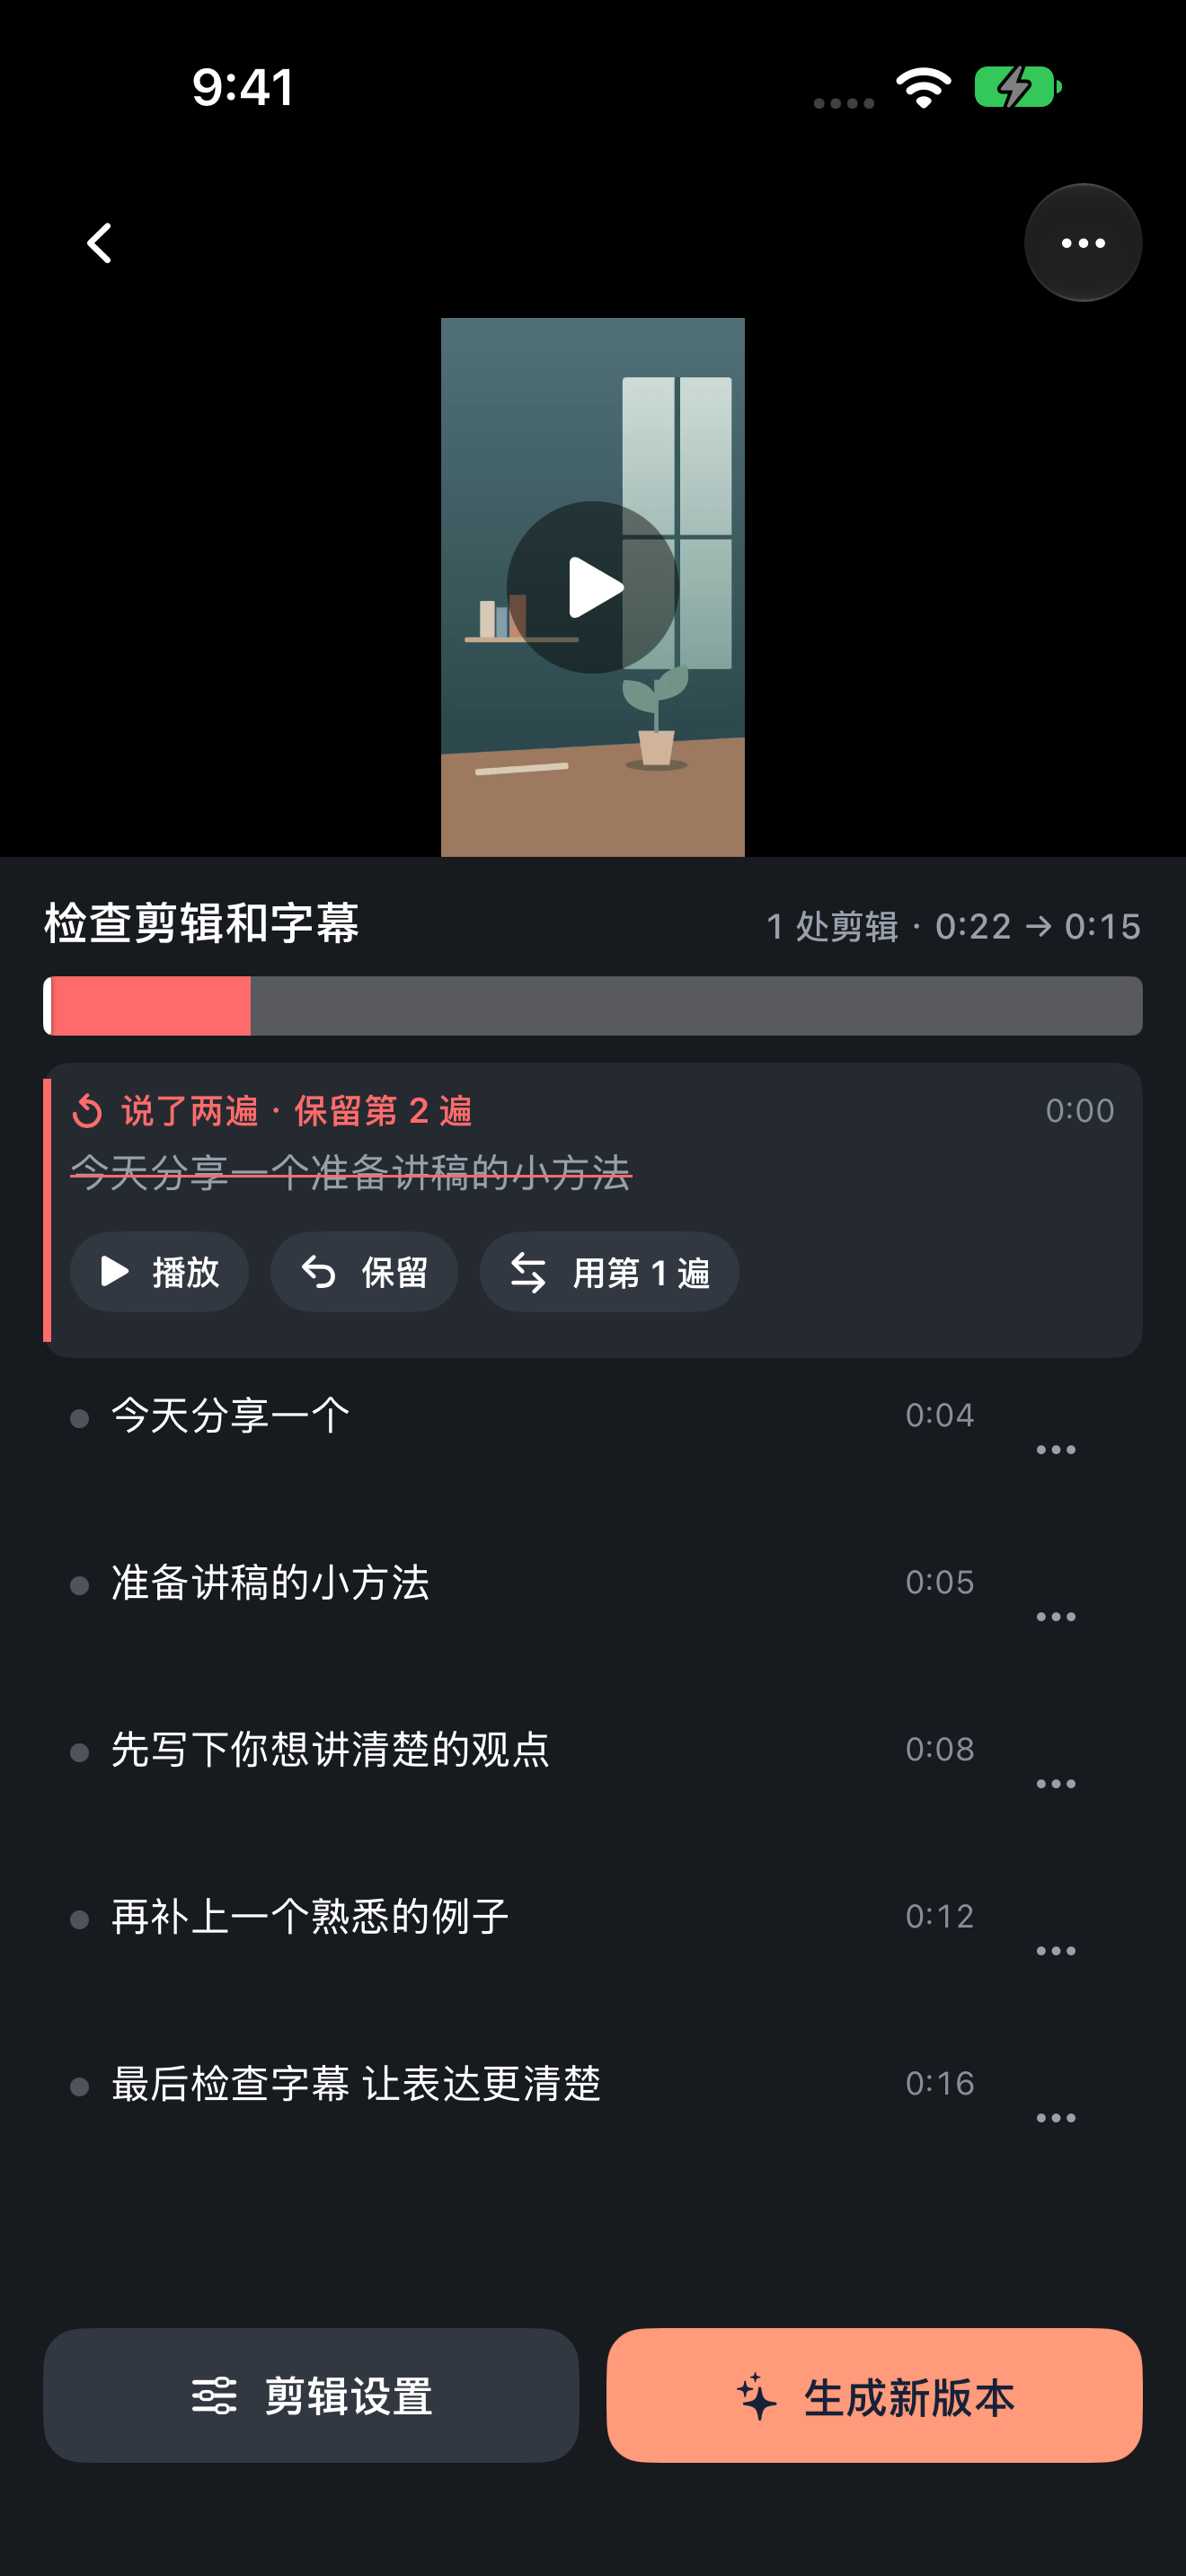
- 开启“先检查再出片”,默认关闭。关着时会先渲染,你只能在成片后再检查重做。
- 先看“待检查”里被标记的行,再切到“全部行”把其余的也过一遍。被标记只是提示要看,没被标记不等于一定对。
- 每一行先播放对应的声音,再决定字怎么改。
先渲染不代表字幕都检查过了。成片后发现问题,回到这条录制改字幕、重新生成即可。
3. 改字不改时间
用某一行的编辑动作改正文字并保存,这行的时间范围不变。如果是时间对不上,改文字解决不了同步问题;请看最终成片,并带 App 版本把问题反馈给支持。
标注“与稿子一致”或“稿子之外”的提示,只是让你去看,不是说临场加的那句一定是错的。被隐藏的行,先决定要不要显示,别默认省略就是对的。
4. 一张保意思的核对清单
- 否定词:“不是”“没有”“不会”有没有被识别成肯定。
- 数字与单位:金额、日期、次数、百分比、范围,逐个对声音。
- 人名与术语:同音字最容易错,比如“林知远”被写成别的字。
- 限定词:“可能”“通常”“这种情况下”有没有丢。
- 剪切处:被剪掉重念的前后两行,拼起来是否完整。
这些检查保的是你表达的意思。FoxTake 不会替你核实医疗、法律、财务等专业事实。
5. 2.0.1 的数字疑点复核与个人词表
数字疑点语音复核:开启 AI 功能授权、本机识别出的普通话数字或单位与明确对应的稿句不一致、复核服务可用,这三个条件同时满足时,App 可以按需把这一句(每段最多 30 秒)的音频发到境内服务器,由阿里云百炼北京的语音识别模型再识别一次,作为核对数字的第二份依据。不附提词稿、预期数字和画面;按实际请求扣积分,成功结果缓存后不再重复发送。它只是辅助,不承诺自动纠正所有数字,最后仍要你听一遍。
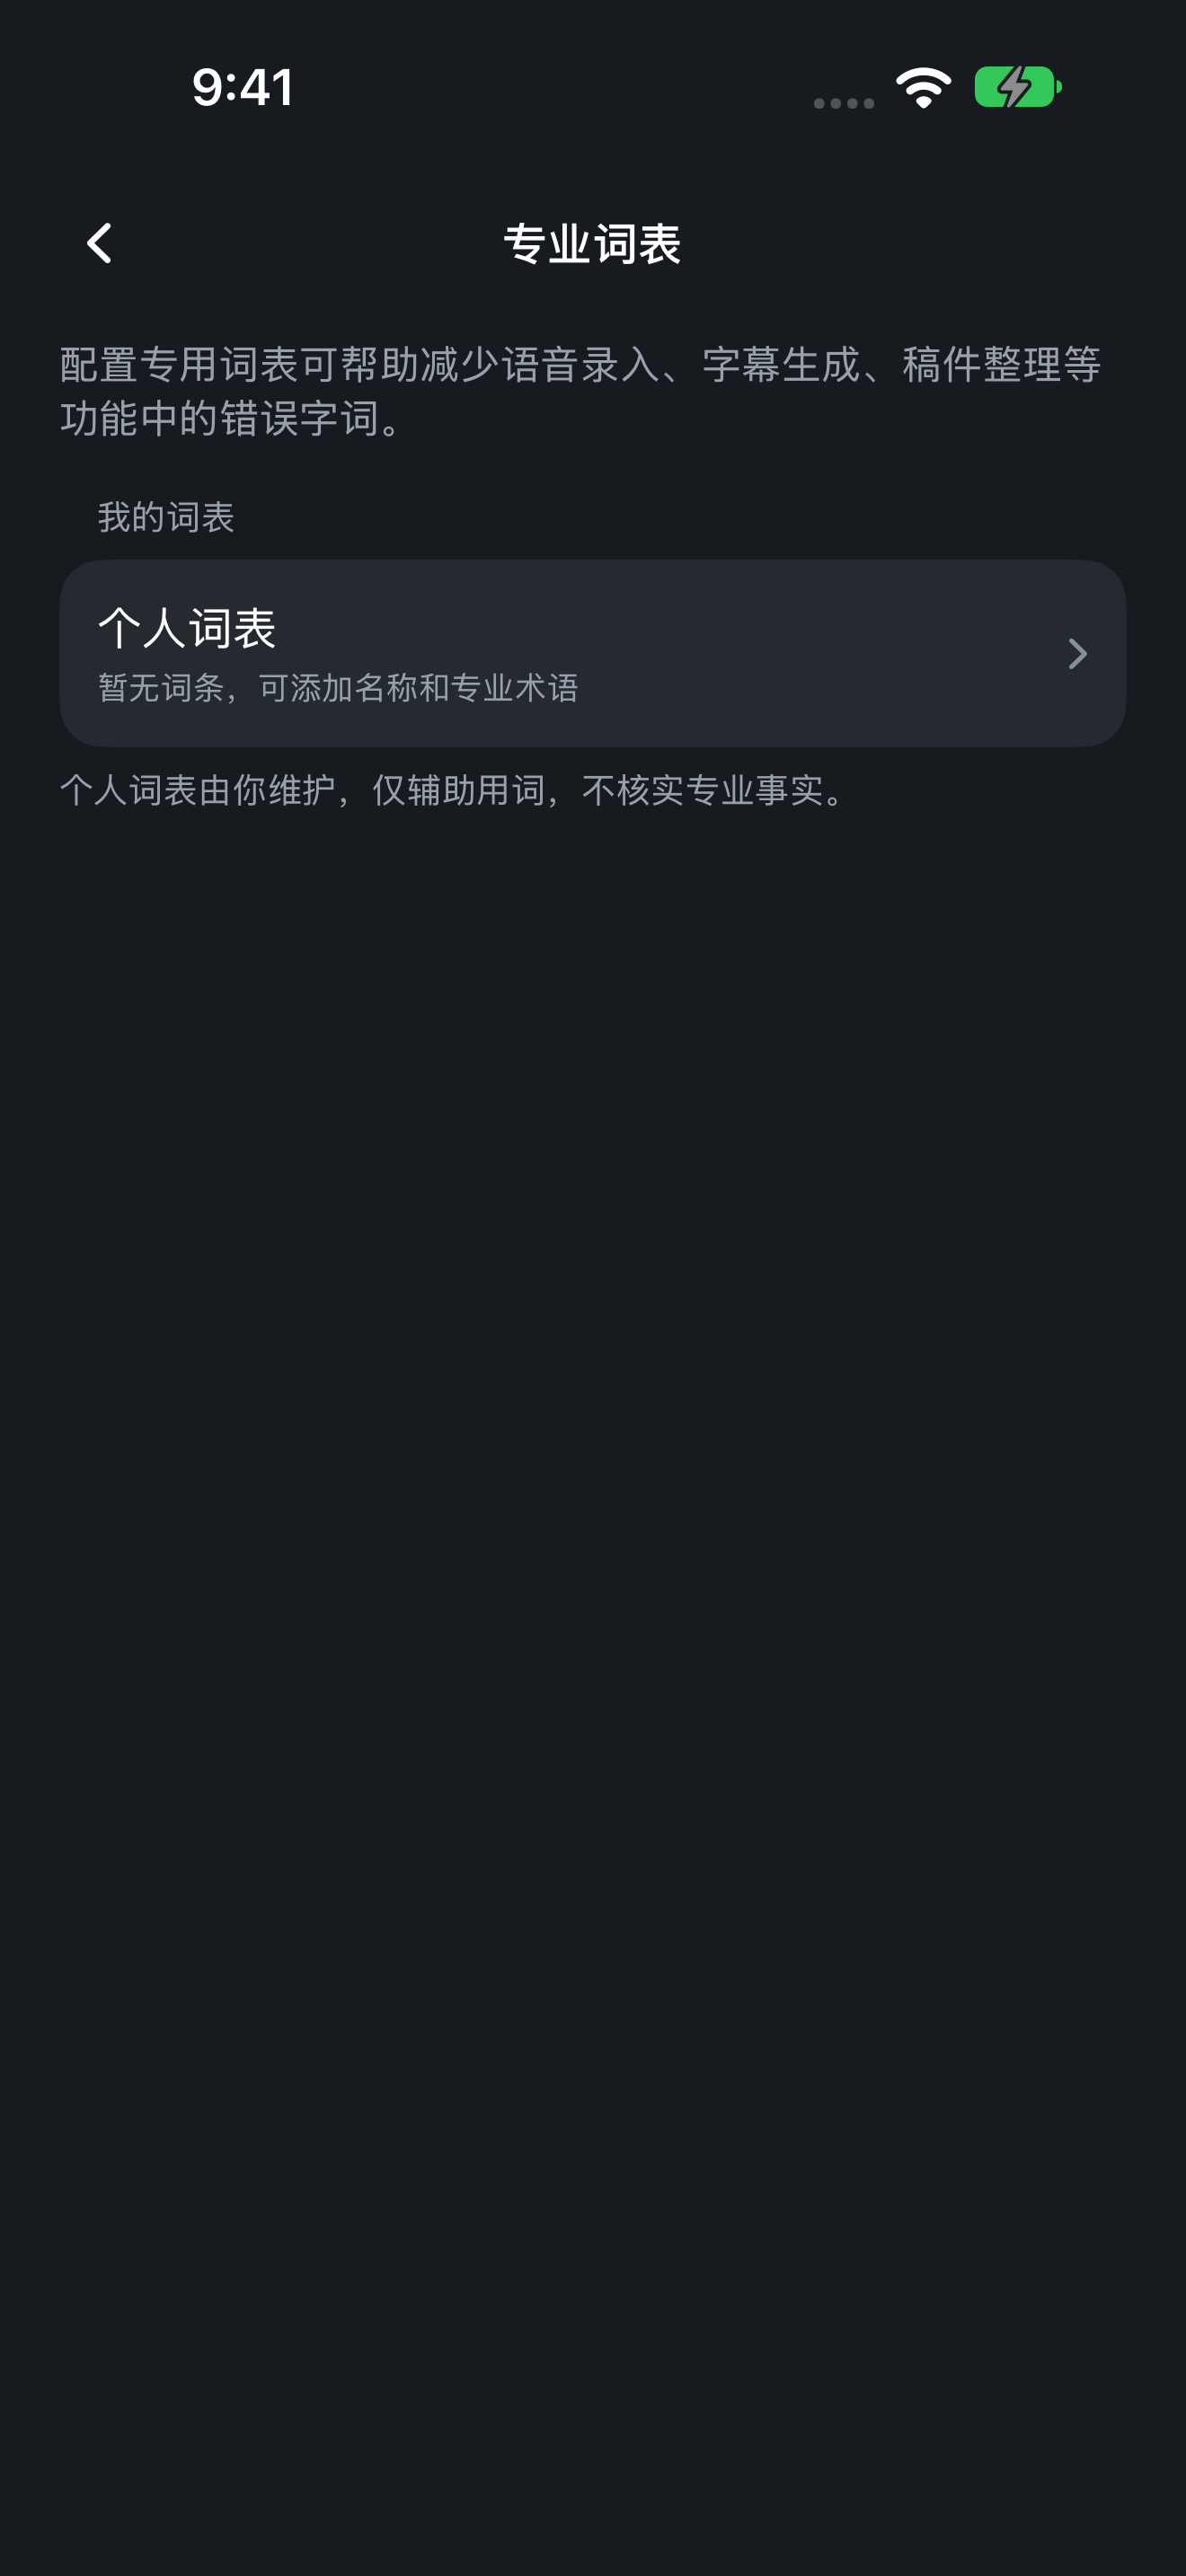
个人词表:在本机维护常用的人名、术语和写法,辅助整理用词。本版不使用专业领域词表,也不会从你的修改里自动学习;它不保证识别一定按词表输出,所以清单里的人名和术语照样要核。
6. 烧录进视频,还是导出 SRT
- 烧录:字幕成为画面的一部分,发到哪里都显示,但事后不能改字和样式。适合直接发布。
- SRT:单独的字幕文件,与同一版成片的时间线对应,交给平台或剪辑软件时可以再改。能否导入和显示取决于接收方。
- 两者都要:发布用烧录版,留档和后期用干净视频加同版 SRT。
普通话字幕默认简体,粤语字幕默认繁体,可切换字形。改过字幕后要重新生成,SRT 才会包含修改;工程导出包里的字幕按原片计时,不等于成片的 SRT。后期去剪映或专业软件继续做,见导出后继续剪辑。
7. 加了第二语言字幕,要单独再核一遍
中文和粤语可以加英文字幕,英文可以加简体或繁体中文字幕。在线翻译在开启 AI 功能授权后发送字幕文字,扣积分。先把源语言字幕改对,再看译文:日期、单位、限定词和否定词再对一次。翻译错了又改不了,就保留源语言版本,发布前去掉译文。语言对和资源要求见语言与字幕支持。
本文依据 2.0.1 公开版本的商店说明和已发布实现编写,配图是发布源码在模拟器重编译的界面,字幕内容为合成样例,不是真机实拍或识别准确率测试;按钮文字以当前 App 界面为准。
用一段带数字的短稿试一次
故意放一个人名、一个日期和一句“这不是……”,录完按清单核一遍,你就知道自己的内容最容易错在哪。